Skyflow Monitor
Bevakar servrar, nätverk, databaser och Azure från egna noder i varje miljö. Monitor larmar först när ett fel består, håller tillbaka följdlarm och öppnar ett ärende kopplat till rätt post i CMDB — som stängs när felet är borta.
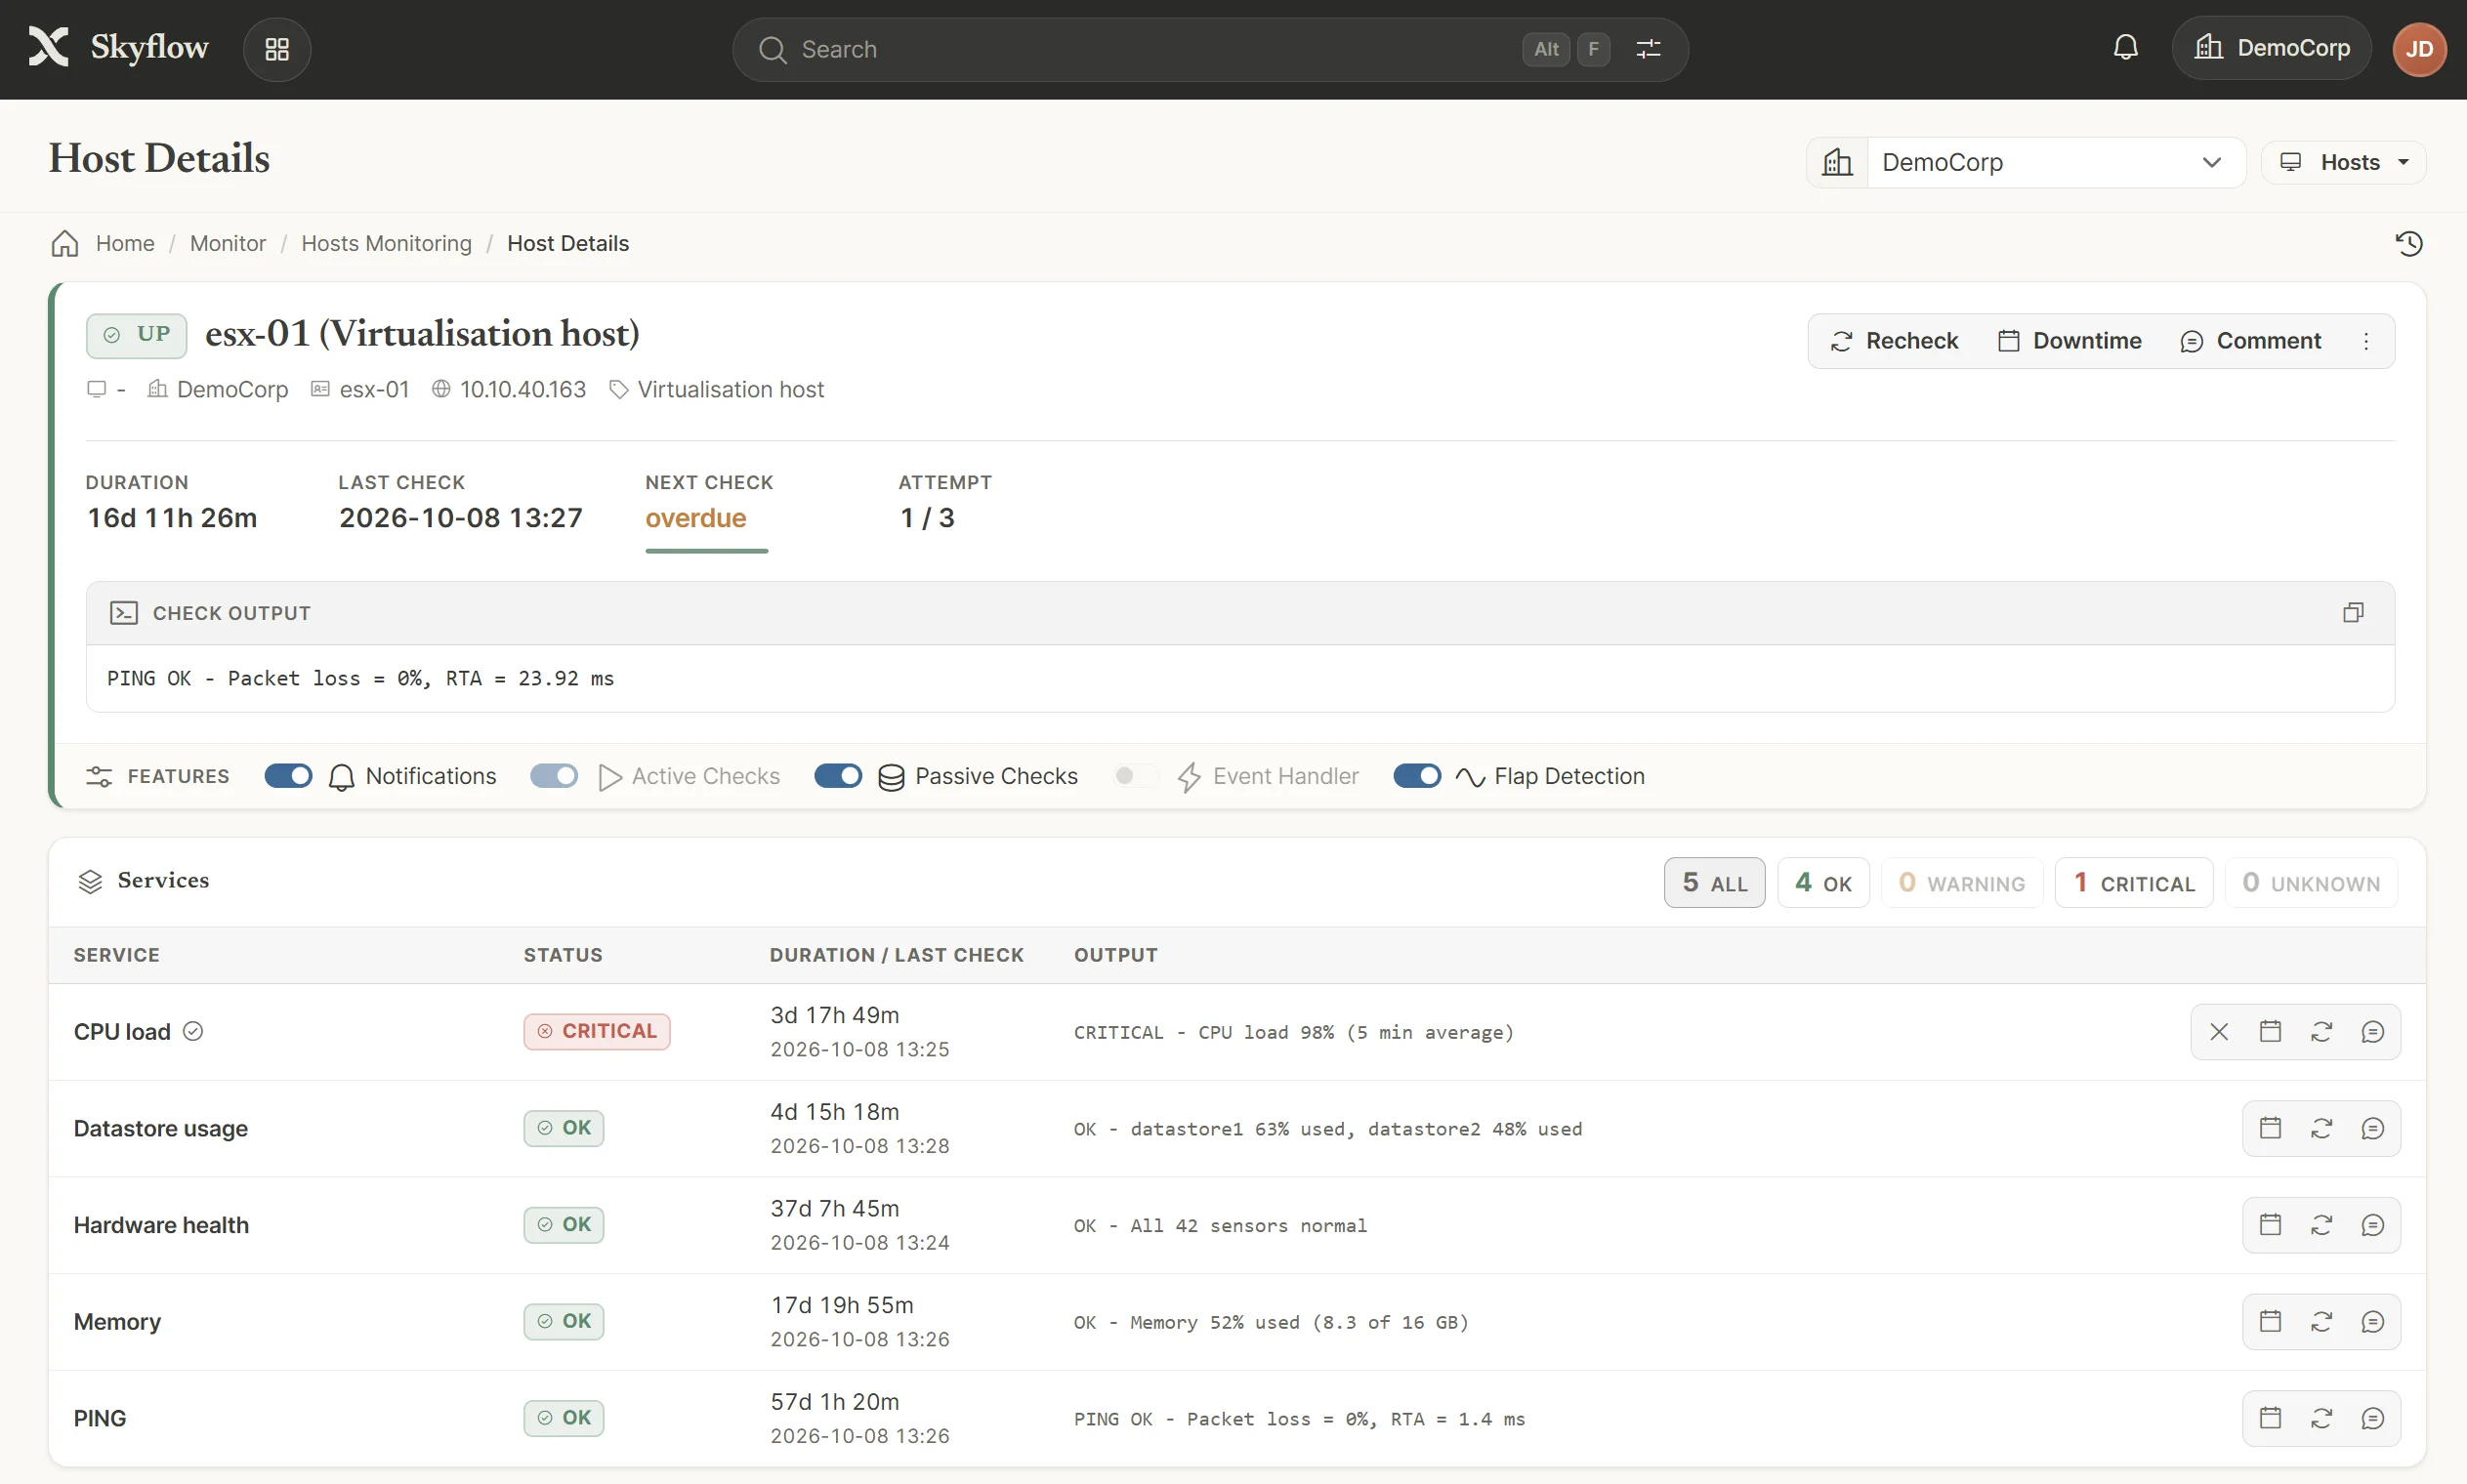
Ett avbrott ger ett larm om orsaken — inte femtio om symtomen, och inget alls för ett fel som rättar sig självt.
Larm, ärende och CMDB-post hänger ihop: ärendet öppnas och stängs av sig självt, och en avvecklad server slutar larma.
Varje ändring provkörs på noden innan den rullas ut och kan rullas tillbaka — en felskriven kontroll blir inte tyst i tre veckor.
Så fungerar det
Bevakar servrar, nätverk, databaser och Azure från egna noder, och larmar först när ett fel består.
Värdet sitter i det som händer runt larmet: följdlarmen som hålls tillbaka, ärendet som öppnas och stängs av sig självt, och ändringen som provkörs innan den går live.
En kontroll som slår av och på hela tiden känns igen och slutar larma för varje växling. Kvittenser går ut efter en tid, så ett bortglömt larm kommer tillbaka i stället för att tystna.
Eskaleringskedjor, notisprofiler och tidsperioder styr när ett larm ska gå och till vem. För varje larm syns varför notisen gick ut — eller inte gick ut — så ingen behöver gissa.
Ändringar från flera i teamet samlas och granskas innan de går ut. En server som läggs i en grupp får gruppens kontroller, så tjugo nya servrar är en ändring, inte tjugo.
Varje miljö, plats eller kund får en egen nod. Tappar en nod kontakten kommer ett larm om det, och dess servrar visas som okända — tystnad betyder aldrig att allt är grönt.
Vill ni se hur det fungerar?
Vi visar de appar som är relevanta för er, i en testmiljö. Ingen genomgång av hela katalogen.